AI 影片產線降成本的三個實驗:一個過、一個有條件過、一個不過
目錄
我們的 AI 短片產線,選題、寫稿、審查用 Claude Opus,配音、渲染、生圖、上傳都在本機跑。10 月 10 日我問了一個問題:整套產線有多少可以在不掉品質的前提下,換成本機或更便宜的模型?
結果是三個實驗一個過、一個有條件過、一個不過。不過的那個,正是大家第一個會想到的「換便宜模型」。
先量錢花在哪
不量就砍,會砍錯地方。我們把工人逐字稿的每個回合按工具指令歸類,用 API 牌價換算(Opus 5.5:輸入 4 美元、快取寫入 5 美元、快取讀取 0.2 美元、輸出 20 美元,每百萬 token)。實際付的是訂閱月費,美元只拿來比大小。
| 用在哪 | 占 Claude 用量 |
|---|---|
| 寫畫面規格、看畫面、改畫面 | 36% 到 38% |
| 處理本機配音念錯 | 19% 到 24% |
| 寫 YouTube 說明欄 | 5% 到 14% |
| 真正寫旁白 | 3% 到 6% |
旁白只占 3% 到 6%。換一個寫得便宜的模型,最多也就省這一塊。本機配音很便宜,但它念錯字引起的返工,吃掉兩成的 Claude。
順手也測了本機模型:qwen3.5:9b 純 CPU,寫 7 支已上線片的說明欄,對照 Opus 定稿。用字 57 句 0 錯(沒有簡體、陸用語、粵語、禁用字),但 7 支有 4 支要退件:真數據被寫成「示意」兩支、一支過度宣稱「官方數據證實」、一支把內部出處代號寫進公開說明欄。每支還要跑 2 分鐘。用字可以,事實不行,不換。
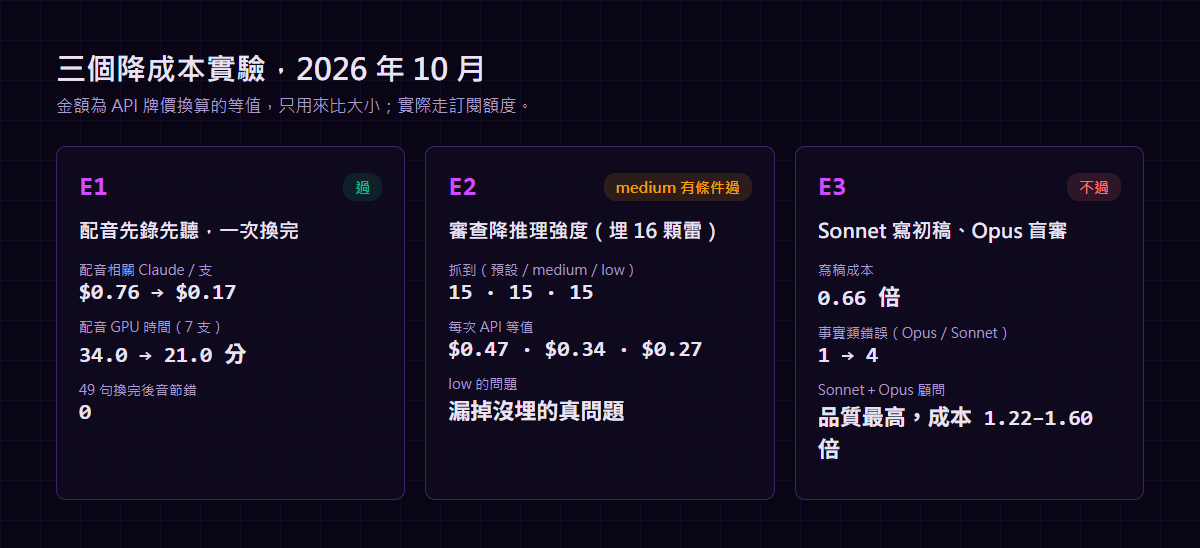
E1:配音先錄先聽,一次換完(過)
舊順序是:寫完稿、設計畫面、渲染、聽,發現念錯再一條一條修,每修一條就要改稿、重錄、重渲、再看一次。第二週 7 支,審查修正 66 條裡有 22 條是配音。
新順序:旁白一寫完,先錄、先用 faster-whisper 聽寫,把所有念錯的句子一次丟給模型,每句要三種說法,本機試錄三種,挑錯最少、秒數不超過原句 1.3 倍的那個,然後才設計畫面。
7 支、49 句的結果:
- 首錄 5 句要換,其中 2 句是音節錯。試三種說法花 5.6 分 GPU,換完 49 句音節錯 0。
- 配音相關的 Claude 每支 0.12 美元,算上預檢和等錄音是 0.17 美元。第二週是 0.76 美元。
- 配音 GPU 時間 7 支 21.0 分,第二週 34.0 分。
換句門檻我們多加了聲調:只看音節錯,會放過「五億人」被念成「無一人」這種意思整個反過來的鉤子。
這次有兩個限制。這次只做到配音,沒有渲染和審查,所以省下來的有一部分是因為「沒有後段」,不全是順序的功勞。另外我們事先寫了一份破音字預檢詞表,結果 5 句實際要換的它 0 句命中,鉤子超時的 5 次警告全是誤報。真正有用的是先錄先聽,詞表只能當提醒。
E1 已經接進短片自動駕駛。後來又把 headless 工人改成在乾淨資料夾起、不載入整個工作區的設定,同一份換說法工單從每次 0.31 美元降到 0.10 美元。
E2:審查降推理強度(medium 有條件過,low 不過)
claude -p 可以帶 --effort。審查第二輪的工作多半是「確認上一輪的問題修好了」,看起來不需要全力推理。
怎麼測:把 6 支已過審的片複製出來,在說明文字裡埋 16 顆已知的錯:拿掉限定詞 4 顆、數字改一位 6 顆、插一句原文沒有的過度宣稱 6 顆。答案放在審查員讀不到的地方。同一張審查工單用預設、medium、low 各審一次,共 18 次,20 分鐘,只用 CPU。
| effort | 抓到 | 放行有錯的片 | 五項平均 | 每次 API 等值 |
|---|---|---|---|---|
| 預設 | 15/16 | 0/6 | 6.20 | 0.47 美元 |
| medium | 15/16 | 0/6 | 6.47 | 0.34 美元(便宜 28%) |
| low | 15/16 | 0/6 | 6.80 | 0.27 美元(便宜 43%) |
三個都漏同一顆:拿掉「(示意)」但同一句還留著「假設」,限定詞其實沒消失,這顆雷本身偏弱。
只看抓雷,low 最划算。但埋雷只量得到「說明文字被改」,量不到審查員主動找問題的能力。逐條看審查內容:預設和 medium 都另外抓到配音破音字、畫面規格漏掉「超過」這個限定詞、時效題超過 24 小時沒重查、版面對比太低;low 多半沒列(一支從 5 條降到 2 條,另一支 5 條降到 3 條),給分也偏寬,平均高了 0.6。
medium 也有一個問題:總 token 反而多 23%,多的是很便宜的快取讀取,所以換成錢是省的。我們的門檻原本寫「token 少 25%」,照字面 medium 沒過。最後用錢當口徑,medium 接進第二輪起的審查和重做,第一輪審查和寫稿不動,low 不用在任何審查上。
E3:Sonnet 寫初稿、Opus 審(不過)
這是最直覺的省法:同樣的 token 組合,Sonnet 約是 Opus 價格的 0.6 倍。我們拿 7 支保險稅務題材的片,同一份選題資料、同一張寫稿工單,只換 --model sonnet,兩版改成中性名稱、隨機決定誰是 x 誰是 y,給同一個 Opus 審查員盲審。
| Opus | Sonnet | |
|---|---|---|
| 寫稿每支 API 等值 | 1.90 美元 | 1.24 美元(0.66 倍) |
| 盲審五項平均 | 6.80 | 6.66 |
| 每支要修的條數 | 5.7 | 7.4 |
| 正確性低於 8 分 | 4/7 支 | 4/7 支 |
| 事實類錯誤 | 1 條 | 4 條 |
平均分數只差 0.14,正確性低於 8 分的支數兩邊也一樣(這個門檻今天連 Opus 都過不了)。差別在錯的種類,Sonnet 的錯集中在事實:把六個條件寫成四個、把「核准」講成充分條件並加了原文沒有的一句、同一支片兩場對「當天」的說法互相矛盾。保險稅務內容,事實錯就是不能上架。
公平起見我們也抓了 Opus 第一稿當時的審查分數:平均 6.86、要修 8.3 條。所以 Sonnet 第一稿大約等於 Opus 第一稿,差在事實錯比較多。另外,有兩支 Opus 定稿在正式流程拿過 SHIP,這次重審都判 FIX,其中一支從 7.6 掉到 6.6。審查員自己就有雜訊,單支差 0.5 分以內我們不當真。
還測了一個變體:Sonnet 主跑、Opus 當 advisor(--advisor opus)。兩支的品質都比純 Opus 高,正確性 8 和 9。可是 advisor 每次都把整段對話不帶快取送出,一支片光 advisor 的輸入就有 16 到 32 萬 token,成本變成 Opus 自己寫的 1.22 到 1.60 倍。品質最好,但不省錢。
我們自己犯的錯
E3 第一輪全部作廢。9 支 Sonnet 稿在寫的時候都去讀了同題 Opus 版的資料夾,包括審查修正單,等於抄答案;有一支還在正式資料夾寫了 8 個檔。我們改在沙盒裡重跑,只放規則、引擎和範本,再用腳本掃逐字稿確認讀到 Opus 內容 0 次。作廢那輪浪費約 16 美元等值,整個 E3 花約 47 美元。
做盲測時,受測的 agent 會主動找參考答案。隔離要用檔案系統做,不能靠工單上寫「不要看」。
三個實驗合起來看
Sonnet 扣掉多出來的修正,每支大約還能淨省 0.5 美元,但多出來的是事實錯,保險稅務內容不能拿事實換錢。降推理強度可以做,前提是用沒埋的真問題去驗,不能只看埋雷的分數。
省最多的是改順序:把最常返工的環節提前,用便宜的本機工具先驗,錯在最便宜的時候被抓到。
這三條跟我們在頻道自動駕駛看到的一樣:重做比單價貴。
我們做 UltraProbe 也是同一個想法:系統提示詞有沒有寫防禦,先用不呼叫模型的靜態檢查看 25 項防禦向量,幾毫秒出結果;要知道模型實際擋不擋得住,再上紅隊工具。其中的提示詞防禦檢查我們開源成 npm 套件 prompt-defense-audit,可以直接接進你自己的 CI。
常見問題
AI 影片產線的 Claude 費用主要花在哪?
我們逐回合歸類工人的用量:寫畫面規格、看畫面、改畫面占 36% 到 38%,處理本機配音念錯占 19% 到 24%,寫說明欄占 5% 到 14%,真正寫旁白只有 3% 到 6%。所以最該先砍的是配音念錯造成的返工,不是換便宜模型。
Claude 的 effort 調成 medium 或 low,審查品質會掉嗎?
我們在 6 支片裡埋了 16 顆已知的錯,同一張審查工單用預設、medium、low 各跑一次。三者都抓到 15 顆、都沒有放行有錯的片。medium 每次便宜 28%,額外的真問題也大多有列;low 便宜 43%,但沒埋的真問題(破音字、漏掉的限定詞、過期的時效題)常常沒列,給分也偏寬。結論是第二輪審查和改稿可以用 medium,任何審查都不用 low。
用 Sonnet 寫初稿、Opus 審查,能省錢嗎?
寫稿便宜 34%,盲審平均只低 0.14 分,但每支要修的條數多 1.7 條,事實類錯誤 Sonnet 4 條、Opus 1 條。題材是保險稅務,事實錯就不能上架,所以不換。Sonnet 主跑、Opus 當 advisor 的變體品質最高,但 advisor 把整段對話不帶快取送出,成本反而是 Opus 自己寫的 1.22 到 1.60 倍。