讓 agents 自己出 YouTube 短片:一支約 25 萬 token、3 美元,四次真跑的帳本
10 月 12 日晚上,我對自己的 YouTube 頻道定了一個要求:要「持續進步而且自主運作」。我們手上本來就有一條短片自動駕駛,那天晚上把它延伸成頻道自動駕駛,先接六個主題頻道:三個已經開始排片,三個準備開台。第一次全自動跑排在 10 月 19 日週一清晨。
這篇不講願景,只講帳本。從 10/12 晚上到 10/13 早上,我們真跑了四支片,每支都記了 token。數字很難看,然後變好,原因跟我們一開始猜的不一樣。
一週跑一次的七步
每週一 04:30 排程叫起 autopilot.mjs,依序跑:
- metrics:只讀,抓每支片的觀看、完看率、訂閱。
- comments:只讀,找觀眾在留言點名的題目。
- learn:每個頻道一個 agent,只改該頻道的規則檔(PLAYBOOK)。沒有任何片有完看率、沒有留言點名、我也沒評分,這一步不叫模型,直接跳過。
- select:從題庫挑本週的題。留言點名而且人數夠的最多 1 題,再從完看率中位數最好的題目家族補(同家族至少 3 支才排名),最後留 1 題當實驗。
- produce:每題一個 Opus 工人出片,出完交給另一個 Opus 審查員看拼圖和逐格圖,判 SHIP、FIX 或 BLOCK。一支最多出片兩次,第二次還不過就標 held,留給人看。
- schedule:用 YouTube API 上傳成「私人+排定時間」,每天 12:00 一支。
- report:寫週報,早上 8 點到晚上 10 點之間才推到 Telegram。
規矩寫死在程式裡:對 YouTube 的寫入只有上傳和排程,不改公開狀態、不刪片、不回留言。
learn 還有一個棘輪:如果某頻道上週改了規則,這週公開片的完看率中位數比上週掉 10% 以上(兩週各至少 3 支),程式自動把規則換回改之前的快照。規則檔最上面一節是我的原話,只准加不准刪,learn 跑完會檢查,違反就整份還原。
四次真跑
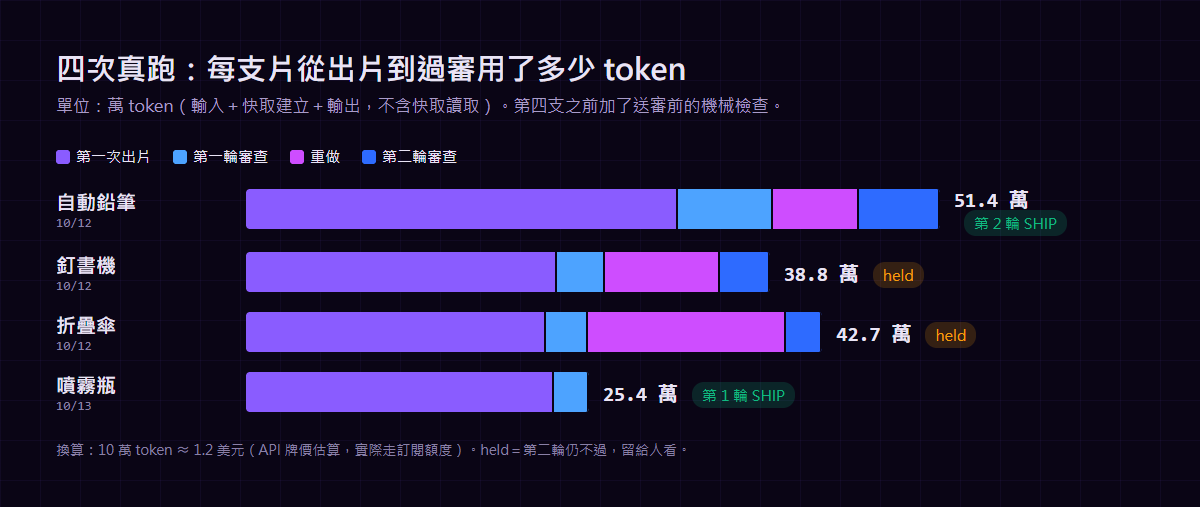
金額怎麼算先說清楚:我們用 10 萬 token 約 1.2 美元換算,token 算輸入、快取建立、輸出,不含快取讀取。這是拿 API 牌價當尺,方便比大小;實際上跑在訂閱額度裡,沒有另外付錢。
第一支,自動鉛筆(10/12 20:32 到 21:03)。 出片第一次 32 萬 token,審查 7 萬,第一輪被打回:彈簧的受力方向畫反了,還有一句話的語意不清。重做只改字,6.4 萬,第二輪審查 6 萬,過了。全程約 51 萬,約 6.2 美元,31 分鐘。比我們以前手動派工人做一支(4 到 11 萬)貴 3 到 5 倍,主因是工人每次從零讀整份交接文件。
第二支,釘書機(21:17 到 21:42)。 先砍讀檔:選題時直接把題庫裡的場景、原理、出處帶給工人;工人和審查員在乾淨的暫存資料夾裡起,不載入整個工作區的設定。全程 38.8 萬,約 4.65 美元。但第二輪仍判 FIX,音效和畫面上的狀態字差了 2 到 3 格,標 held。
第三支,折疊傘(22:0x)。 再砍看圖次數和逐格圖尺寸。第一次出片從 23 萬只降到 22.2 萬,全程 42.7 萬,又 held:兩張原理卡寫了 25 和 26 個字,規則上限是 22 字。
到這裡結論很清楚:Opus 出片第一次的地板大約 20 到 22 萬(輸出約 4 萬,工具回傳約 9 萬),再怎麼砍讀檔也到不了 12 萬。三支的全程會落在 38 到 51 萬,是因為三支都在第一輪被打回,重做 6 到 15 萬,再加一輪審查。
我們一直在省「出片」那一段,真正貴的是「被打回」。
送審前的機械檢查
回頭看審查員挑的問題,有一大類根本不需要模型判斷:卡片超過 22 字、出處表沒寫查證日、標了「示意」的數字在畫面上漏掉限定詞、音效和狀態字切換差太多格、禁用字。
所以我們寫了 gates-script.cjs,純程式,不呼叫模型、不渲染:
- 原理卡一句解釋 ≤ 22 字,算法跟審查員一樣。
- 出處表標「一般/示意/相傳/有爭議」的列,對應的卡片和說明要帶限定詞。
- 出處表每列要有 YYYY-MM-DD 查證日。
- 用 timing 檔算出音效的秒數,跟模型算出的狀態字切換比,差距 ≤ 3 格(24 fps,0.125 秒)。
- 禁用字掃畫面字和上傳說明。
拿三支成品驗:折疊傘 2 FAIL,正好是審查員第二輪抓的那兩張卡;釘書機全過(程式算出 tick 與「碰到凹槽」差 1 格,審查員當時看到的 2 到 3 格是錄影分段的格點造成的);自動鉛筆 1 FAIL,它出片時還沒有查證日這條規矩。
接進流程兩處:工人交片前自己跑到 0 FAIL;程式送審前再跑一次,FAIL 直接退回工人,不算一輪審查、不吃兩次出片的額度。另外加一條分流:審查挑的問題全是文字時,重做只改字、重渲、看一次拼圖,工人不再重看逐格圖。
第四支,噴霧瓶(10/13 09:27 到 09:43)。 出片第一次 22.8 萬,審查 2.6 萬,第一輪 SHIP。全程 25.4 萬,約 3 美元,16 分鐘。
定版的口徑
| 情況 | token | API 等值 |
|---|---|---|
| 一次過 | 約 25 萬 | 約 3 美元 |
| 審查挑文字、只改字重做 | 約 30 萬 | 約 3.6 美元 |
| 時序或因果問題、整支重做 | 38 到 43 萬 | 約 5 美元 |
六台每週 18 支,估 60 到 90 美元等值,全部在訂閱額度內。這是四支的樣本,10/19 真跑一整週之後會再對一次。
還有一個天花板不是 token:YouTube 專案每天 10,000 單位的上傳配額,大約只夠 6 支。一天要傳 9 支時,多的會寫進待補清單,隔天 10:30 由另一個排程補傳,公開日期照原訂,過了才往後排。
人在哪裡出手
全自動不等於沒人。週報每週推一次,人做三件事:
- 回一句口味,例如哪支好、哪支太慢、為什麼,記進該頻道規則檔的原話區,之後每支片都照做。
- 已排的片要取消,回頻道名加日期。
- 處理週報「要你做的」清單。第一週就有一條:讀留言需要
youtube.force-ssl權限,原本的授權只有唯讀,留言讀取一律回 403。10/13 重新授權後解了。
被標 held 的片也會停在那裡,不會自己上架。
這次學到的
模型單價不是最大的槓桿。同一個 Opus,把「審查員一定會挑的機械問題」從審查前移到程式裡,比換便宜模型省得多,也不用賭品質。我們另外測了換模型和降推理強度,結果寫在三個降成本實驗;幾個 agent 同時要用顯卡的問題,寫在渲染鎖那篇。
送審前先跑一層不呼叫模型的檢查,這個做法我們也用在 AI 安全上。UltraProbe 把系統提示詞和工具描述丟進 25 項防禦向量的靜態檢查,幾毫秒出結果,免費。如果你在 Threads 上經營多個帳號,MindThread 是我們自己每天在用的排程發文與留言工具。
常見問題
用 Claude agent 自動出一支 YouTube 短片要多少錢?
我們四次真跑的結果:一次過審約 25 萬 token,用 API 牌價換算約 3 美元;審查挑出文字問題、只改字重做約 30 萬;時序或因果要整支重做約 38 到 43 萬,約 5 美元。金額是 API 等值估算(10 萬 token 約 1.2 美元,不含快取讀取),實際走的是訂閱額度,沒有另外付錢。
成本最大的一塊是什麼?
是重做,不是模型單價。前三支都在第一輪審查被打回,重做加第二輪審查讓全程變成 38 到 51 萬。把審查常挑的機械問題(卡片字數、限定詞、出處查證日、音效和畫面差幾格、禁用字)寫成不呼叫模型的程式檢查,放在送審前讓出片的 agent 自己修,第四支就一輪過,全程 25.4 萬。
全自動的頻道,人還要做什麼?
三件事:在週報回一句口味(例如哪支好、哪支太慢),會被記進該頻道的規則檔;要取消已排定的片,回頻道名加日期;處理週報列出的待辦,例如重新授權。其餘從選題到排程都由程式和 agent 跑。